
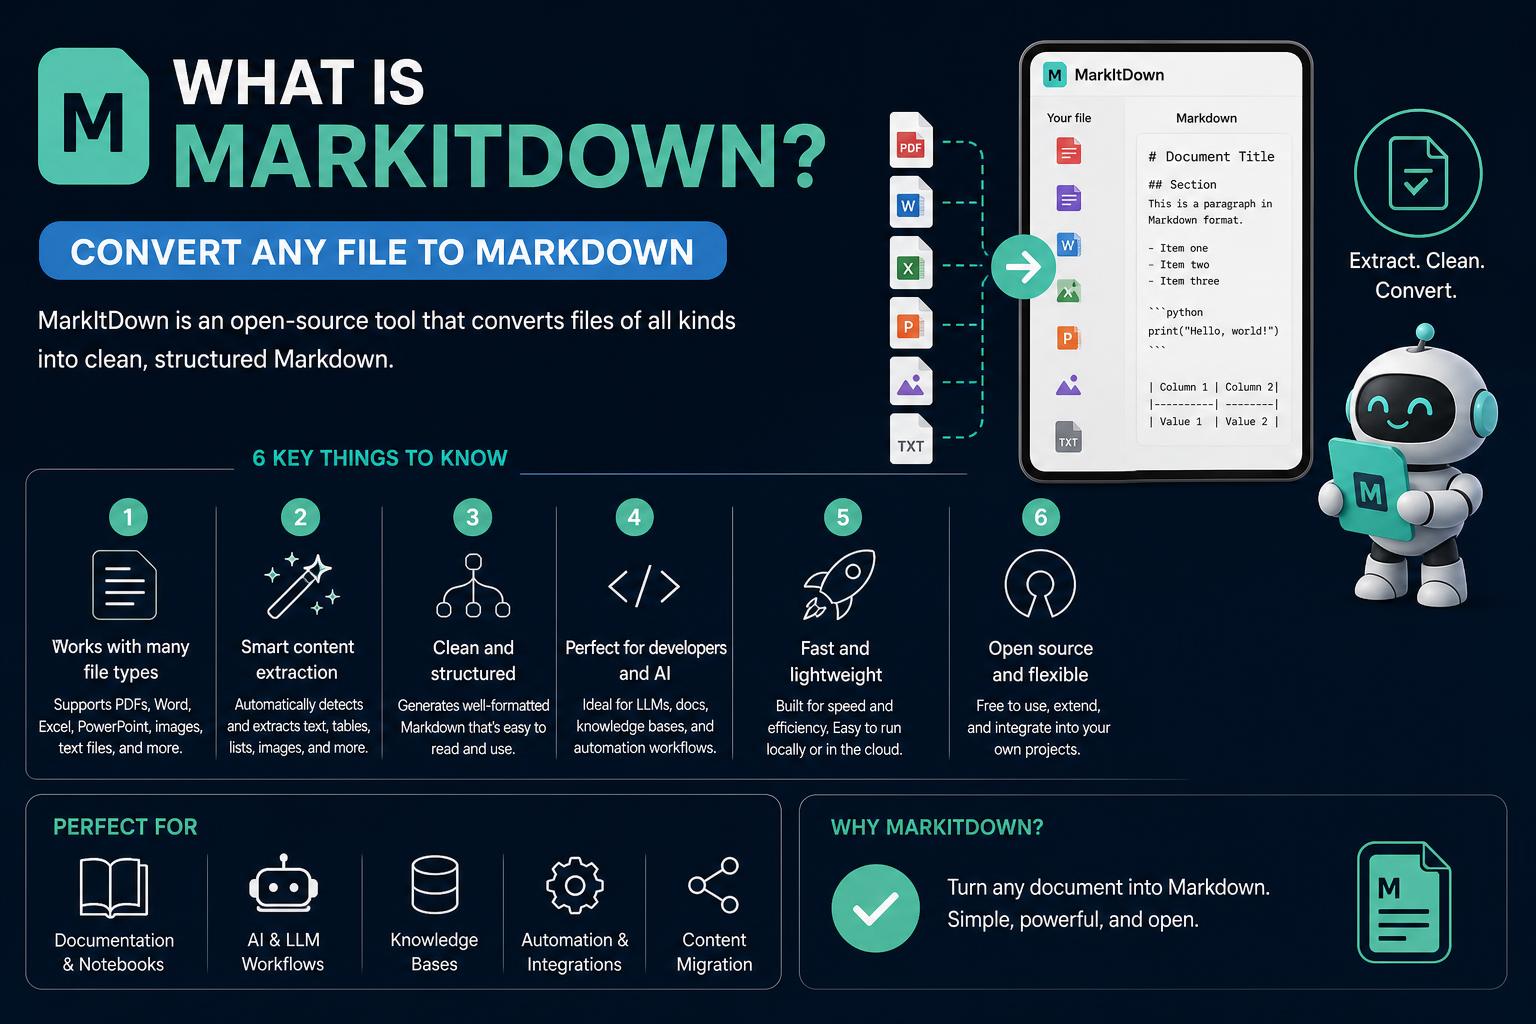
- MarkItDown — это мощный инструмент с открытым исходным кодом от Microsoft для преобразования различных файлов в формат Markdown.
- Он поддерживает широкий спектр форматов, включая PDF, документы Office, изображения и аудио с расширенными возможностями извлечения данных.
- Благодаря расширяемой архитектуре, поддержке плагинов и интеграции с VS Code, он адаптируется к современным рабочим процессам и обучению по программе LLM.
Цифровое пространство переполнено документами, электронными таблицами, презентациями и разнообразными форматами, которые редко говорят на одном языке. Если вам когда-либо приходилось преобразовывать проблемный PDF-файл, таблицу Excel или даже изображение в чистый, структурированный Markdown, вы, вероятно, сталкивались с многочисленными трудностями. На помощь приходит MarkItDown — инструмент, который быстро становится востребованным решением для разработчиков, специалистов по работе с информацией и энтузиастов искусственного интеллекта, стремящихся к беспроблемному преобразованию файлов.
В этом подробном руководстве мы разберем, что такое MarkItDown, чем он отличается от других инструментов, что делает его невероятно популярным и как вы можете интегрировать его в свои повседневные рабочие процессы. Мы рассмотрим все аспекты, от его технических возможностей до реальных примеров использования, советов, возможностей для разработчиков и многого другого . Приготовьтесь к подробному обзору впечатляющего инструментария с открытым исходным кодом от Microsoft!
Что именно представляет собой MarkItDown?
MarkItDown — это легковесная утилита с открытым исходным кодом на Python, разработанная и поддерживаемая Microsoft, которая позволяет конвертировать целый ряд форматов файлов в хорошо структурированный формат Markdown. Хотя существуют и другие инструменты конвертации, MarkItDown выделяется своим акцентом на сохранении точности документа, структуры и ключевых данных , что делает его бесценным не только для читателей-людей, но и для больших языковых моделей (LLM), конвейеров искусственного интеллекта и поисковых индексов, которые эффективно работают с входными данными в формате Markdown.
Эта мощная платформа совместима с версиями Python от 3.10 до 3.14 и, хотя разработана для технических специалистов и разработчиков, достаточно доступна для опытных пользователей, желающих автоматизировать или оптимизировать рабочие процессы с документами.
Почему MarkItDown вызывает такой ажиотаж?
С момента своего публичного выпуска MarkItDown стремительно набрал популярность, собрав десятки тысяч звёзд на GitHub за короткое время. В значительной степени это объясняется его гибкостью, модульной конструкцией и широким спектром поддерживаемых типов файлов.
- Офисные документы (Word, PowerPoint, Excel): Преобразует любой текст в таблицы и списки, сохраняя при этом заголовки и структуру содержимого.
- Изображения (JPEG, PNG, GIF): Извлекает метаданные EXIF и может генерировать расширенный альтернативный текст или подробные описания при подключении к LLM.
- Аудиофайлы (MP3, WAV): Выполняет транскрипцию речи в текст для извлечения значимого контента — даже из голосовых заметок или записей.
- Веб-форматы и форматы данных (HTML, JSON, XML, CSV): Преобразует сложные массивы данных и таблицы в понятные эквиваленты Markdown.
- ZIP-архивы: Программа перебирает все включенные файлы, преобразуя каждый из них по мере необходимости.
- Видео- и расширенный анализ документов (с помощью Azure Content Understanding): Предлагает многомодальную конверсию, включая извлечение полей из счетов-фактур, квитанций и мультимедийного контента.
Главное преимущество заключается в высокой «токеновой эффективности» и совместимости выходных данных с популярными моделями ИИ. Большинство современных моделей LLM, от GPT-4 от OpenAI до собственных моделей, изначально «говорят» на языке Markdown. Microsoft даже отмечает, что такие модели обучаются на огромных объемах текста в формате Markdown, поэтому использование MarkItDown помогает предоставлять данные как людям, так и машинам в наиболее удобной для восприятия форме.
Поддерживаемые форматы файлов — что может обрабатывать MarkItDown?
MarkItDown особенно ценен благодаря широкой поддержке файлов. Вот подробный обзор того, что он обрабатывает «из коробки» и с помощью плагинов:
- PDF: Извлечение текста с возможностью распознавания текста (OCR) через плагины для отсканированных документов в виде изображений.
- Word (.docx), PowerPoint (.pptx), Excel (.xlsx): Переводит файлы офисного пакета, сохраняя текст, структуру, таблицы, слайды и заголовки.
- Изображения (PNG, JPG, JPEG, GIF): Извлекает EXIF/метаданные и может использовать LLM-модули или специальные плагины для генерации описательного альтернативного текста.
- Аудио (MP3, WAV): Использует распознавание речи для преобразования речи в текст в формате Markdown.
- Веб-форматы и данные (HTML, CSV, JSON, XML): Сохраняет структуру макета и таблиц, где это возможно, позволяя получать таблицы Markdown непосредственно из исходного контента.
- Архив ZIP-архивов: Рекурсивная обработка содержимого делает пакетные преобразования быстрыми и эффективными.
- Ссылки на YouTube: При активации плагинов программа получает и расшифровывает видеоконтент.
- Электронные книги (EPUB): Преобразует файлы EPUB в читаемый формат Markdown.
Дополнительные зависимости расширяют функциональность: Вы можете установить дополнительные модули в зависимости от того, нужны ли вам файлы PDF, PowerPoint, DOCX, XLSX, аудиозаписи и многое другое. Команда pip install 'markitdown[all]' Он захватит все данные, или вы можете настроить его под свои нужды.
MarkItDown против других инструментов преобразования файлов
В то время как популярные инструменты, такие как textract, предлагают извлечение данных из различных форматов, MarkItDown фокусируется на выводе в формате Markdown, сохраняющем структуру документа. Это означает, что вы получаете не просто текстовый дамп; вы получаете заголовки, списки, таблицы и ссылки, представленные в формате настоящего Markdown. Это очень важно, если вам важна читаемость документации, простая миграция в базы знаний или бесперебойная передача данных в LLM для контекстно-зависимых ответов.
Как работает MarkItDown изнутри?
Архитектура MarkItDown отличается чистотой, модульностью и возможностью расширения. Основная логика размещена в классе DocumentConverter, от которого наследуются все конвертеры, ориентированные на определенные типы файлов. Эти конвертеры регистрируются динамически, поэтому поддержка новых или нишевых форматов может быть легко добавлена сообществом разработчиков с помощью плагинов.
Например:
- Офисные файлы: Такие инструменты, как
mammothиpandasиспользуются для преобразования в HTML, а затем трансформируются в Markdown с помощьюBeautifulSoup. - PDF: рычаги извлечения
pdfminerс возможностью добавления плагинов для распознавания текста в отсканированных файлах. - аудио: Интегрируется
speech_recognition(по умолчанию используется API Google) для преобразования речи в текст, хотя для более высокой точности или для конкретных сценариев использования возможна интеграция с OpenAI или Azure. - Файлы изображений: По умолчанию может обрабатывать метаданные EXIF и вызывать LLM для создания описаний на естественном языке или тегов alt.
MarkItDown может работать полностью в автономном режиме для поддерживаемых типов файлов или подключаться к API и плагинам сторонних разработчиков для решения сложных задач извлечения данных, таких как распознавание текста (OCR) или получение субтитров с YouTube.
Интеграция с LLM и рабочими процессами ИИ.
Одно из главных преимуществ MarkItDown — это подготовка документов для обучения в магистратуре и поиска с использованием искусственного интеллекта. Независимо от того, собираете ли вы контекстные данные для чат-ботов или переносите корпоративные вики, Markdown — это идеальное решение: компактный, легко обрабатываемый и удобный как для людей, так и для машин. Ориентация MarkItDown на эффективность использования токенов и сохранение структуры означает, что как автоматизированные инструменты, так и редакторы-люди получают одинаковую выгоду от его преобразований.
Современные программы обучения с использованием языка программирования LLM, такие как предлагаемые OpenAI, лучше всего реагируют на структурированный контент, насыщенный Markdown-кодом. Таким образом, подход MarkItDown дает вам преимущество в любом рабочем процессе, связанном с ИИ, требующем извлечения информации или усвоения знаний.
Экосистема плагинов — неограниченное расширение форматов.
Если основных форматов недостаточно для ваших нужд, MarkItDown поддерживает сторонние плагины, которые открывают еще больше возможностей.
- Плагины могут добавлять поддержку специализированных типов файлов, расширенное распознавание текста (OCR) или альтернативные рабочие процессы извлечения данных.
- Найдите плагины, используя #markitdown-plugin используйте хэштег на GitHub или создайте свой собственный, используя в качестве образца следующий хэштег:
markitdown-sample-pluginрепозиторий. - Плагины являются необязательными и должны быть явно включены, обеспечивая вам безопасность и контроль над вашей средой.
Одним из наиболее примечательных является плагин markitdown-ocr , который позволяет использовать нейронное оптическое распознавание текста в PDF-файлах, DOCX-файлах, PPTX-файлах и XLSX-файлах для извлечения текста из встроенных изображений с помощью моделей компьютерного зрения — без необходимости использования отдельных библиотек!
Расширенные возможности: Azure Document Intelligence и Content Analysis
Для пользователей с расширенными задачами извлечения данных, такими как высококачественное оптическое распознавание текста (OCR), извлечение структурированных полей или преобразование многомодального контента, MarkItDown предлагает интеграцию с Azure Document Intelligence и Azure Content Understanding (CU).
- Azure Document Intelligence: Использует облачную технологию извлечения структуры для сложных PDF-файлов и структурированных документов.
- Понимание содержимого Azure: Обеспечивает извлечение метаданных YAML для полей, специфичных для предметной области (суммы счетов, пункты договора), поддерживает мультимодальные файлы (аудио, видео, изображения) и позволяет настраивать пользовательские анализаторы.
Эти интеграции, конечно, платные (за каждый вызов API), но они обеспечивают извлечение данных корпоративного масштаба в облачные рабочие процессы — это крайне важно, когда ваши задачи требуют точности или поддержки нескольких форматов, выходящих за рамки возможностей локальных вычислительных систем.
Простая установка и использование
- Установка через PyPI:
pip install 'markitdown[all]'(Настоятельно рекомендуется для использования всех функций) - Источник: Клонировать официальный репозиторий GitHub Для максимальной гибкости следуйте инструкциям по установке.
Инструмент командной строки
Если вам нравится работать в терминале, MarkItDown поставляется с простым интерфейсом командной строки. Просто выполните:
разметка -о
Эта команда преобразует ваш файл и поместит полученный результат в формате Markdown туда, куда вам нужно. Вы можете объединять команды для пакетного преобразования или автоматизировать этот процесс в скриптах.
Python API
Для разработчиков и специалистов по автоматизации MarkItDown предоставляет простой API на языке Python:
from markitdown import MarkItDown md = MarkItDown() result = md.convert('test.xlsx') print(result.markdown)
Это значительно упрощает интеграцию MarkItDown в ETL-конвейеры, системы сбора данных или рабочие процессы обучения моделей ИИ.
Виртуальная среда и обработка зависимостей
Во избежание конфликтов зависимостей лучше всего устанавливать MarkItDown в выделенной виртуальной среде. Вы можете использовать встроенную в Python функцию `venv`. uvили Anaconda — адаптируйте настройку под свой стек разработки и избегайте случайного сбоя других проектов на Python.
Безопасность и проверка входных данных
MarkItDown работает с теми же привилегиями, что и ваш процесс Python. Это означает, что, как и при работе с файловым вводом-выводом, вам необходимо внимательно относиться к тому, какие файлы и URL-адреса вы ему передаете. Всегда проверяйте и ограничивайте ненадежные входные данные, особенно если вы интегрируете MarkItDown в размещенные приложения или веб-сервисы.
Используйте максимально узкий API, соответствующий вашим потребностям: придерживайтесь convert_local() для локальных файлов и используйте только convert() Для более широкого круга задач необходимо контролировать доступ инструмента к определенным ресурсам. Не следует напрямую предоставлять доступ к загружаемому пользователями контенту через конвейер конвертации без предварительной проверки и мер безопасности.
Интеграция: расширение для Visual Studio Code и онлайн-платформы.
Если вы пользуетесь VS Code, MarkItDown предлагает удобное расширение через Visual Studio Marketplace, которое позволяет использовать все возможности инструмента Python прямо в вашем редакторе.
- Преобразование правой кнопкой мыши: Мгновенно создавайте файлы Markdown из PDF, DOCX, PPTX, XLSX и других форматов — без необходимости использования терминала. Просто выберите нужные файлы в проводнике, щелкните правой кнопкой мыши и выберите «Преобразовать в Markdown».
- Поддержка пакетной обработки и множественного выбора: Конвертируйте несколько файлов одновременно, не выходя из IDE.
- Изолированная среда Python: Расширение создает собственную виртуальную среду и самостоятельно управляет зависимостями, оставляя системный Python нетронутым для обеспечения максимальной стабильности.
- Управление выводом: Предотвращает перезапись данных, создавая выходные файлы с уникальными номерами, и может автоматически открывать результат после преобразования.
- Поддерживаемые форматы: Аналогично инструменту Python, с прозрачной обработкой изображений, архивов и аудио. Примечание: для распознавания текста в PDF-файлах, содержащих только изображения, требуется плагин или настройка LLM.
- Настройка и устранение неполадок: Измените настройки автоматического открытия и перезаписи файлов, добавив четкие уведомления об ошибках или пустых результатах.
Для тех, кто предпочитает веб-подход, такие платформы, как Markitdown Online, позволяют загружать файлы через браузер и мгновенно получать результаты в формате Markdown, что идеально подходит для легкой миграции баз знаний или создания корпусов для обучения ИИ.
Типичные сценарии использования: почему это важно?
- Перевод статической документации в редактируемый формат Markdown для технических вики и корпоративных интранетов.
- Подготовка документов для загрузки в чат-боты и системы поиска знаний, работающие на базе LLM.
- Пакетное извлечение содержимого и метаданных из больших наборов PDF-файлов, офисных файлов или мультимедийных ресурсов.
- Разработка автоматизированных API-интерфейсов для преобразования файлов в рамках более крупных систем автоматизации (например, с использованием FastAPI, Zapier или n8n).
- Преобразование устаревших форматов для индексирования поисковыми системами или архивирования баз знаний.
Советы, ограничения и возможности для разработчиков
Несмотря на гибкость MarkItDown, следует знать несколько важных моментов:
- Ограничения PDF-файлов: Для обработки PDF-файлов, содержащих изображения, требуется распознавание текста (OCR), и при извлечении может произойти потеря форматирования. Если вам необходимы заголовки и структурные детали, может потребоваться обработка с помощью специального инструмента.
- Аудио и видео: Встроенная функция транскрипции ограничивается простым распознаванием речи. Для повышения точности рекомендуется подключение к Azure или другим расширенным API.
- Производство на заказ: Модульная кодовая база упрощает добавление поддержки новых форматов файлов или интеграцию с внешними сервисами. Приветствуются вклады сообщества — будь то исправление ошибок, новые плагины для работы с форматами или расширение существующих функций.
Для тех, кто заинтересован в развертывании MarkItDown в качестве API, возможно размещение с использованием облачных решений, предлагающих конечные точки с оплатой по мере использования. Такие платформы, как Leapcell, поддерживают бесшовное развертывание API на основе событий — идеально подходит для автоматизации преобразования файлов в распределенных командах без необходимости аренды целого сервера.
Получение помощи и внесение вклада
Сообщество MarkItDown активно и приветствует вклад. Если у вас возникнут какие-либо проблемы, обратитесь в раздел Issues на GitHub, в раздел вопросов и ответов на Marketplace и другие каналы для разработчиков, чтобы получить помощь и идеи. Помните о кодексе поведения и условиях лицензирования Microsoft, особенно если вы участвуете в разработке или распространении модифицированных версий.
Если вы хотите разработать веб-сервис, настольное приложение или оболочку командной строки на основе MarkItDown, это вполне разрешено и даже приветствуется — просто поддерживайте его как отдельный пакет, ссылающийся на основную библиотеку из PyPI ( см. PyPI здесь ).
MarkItDown — это универсальный инструмент, который может значительно оптимизировать рабочие процессы обработки документов благодаря поддержке широкого спектра форматов, высокой точности отображения Markdown и возможностям расширения. Интеграция с рабочими процессами ИИ и экосистемой плагинов делает его особенно мощным инструментом для автоматизации и обработки больших объемов данных.