
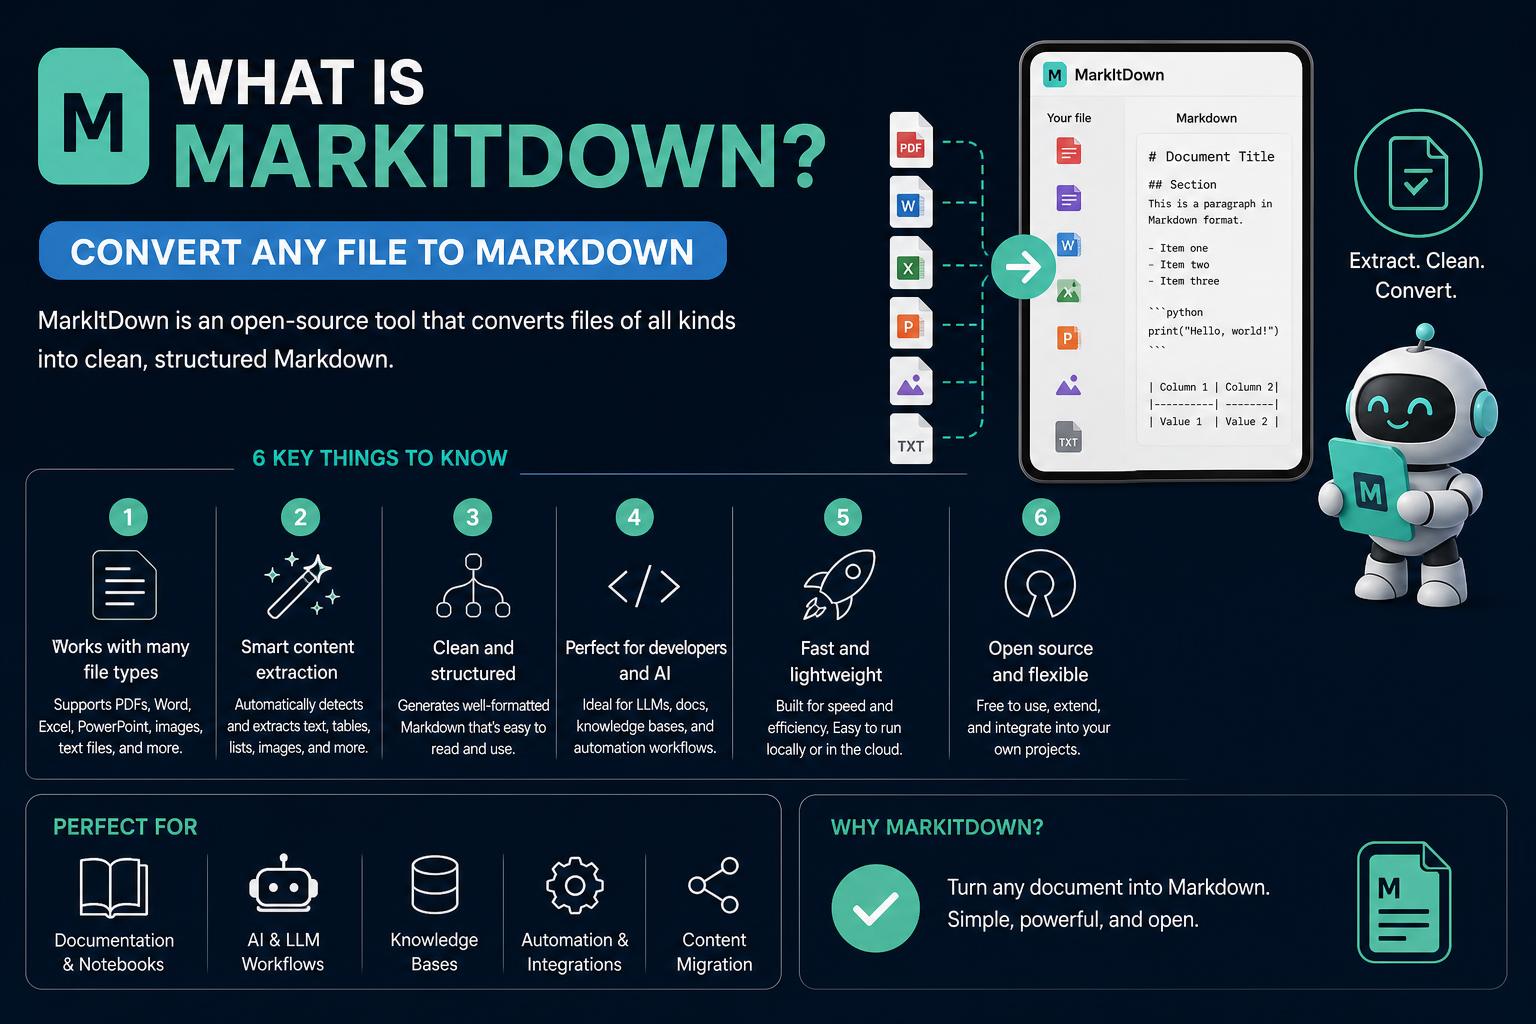
- MarkItDown är ett kraftfullt verktyg med öppen källkod från Microsoft för att konvertera olika filer till Markdown.
- Den stöder ett brett utbud av format, inklusive PDF, Office-dokument, bilder och ljud med avancerad extrahering.
- Dess utbyggbara arkitektur, plugin-stöd och VS Code-integration gör den anpassningsbar för moderna arbetsflöden och LLM-utbildning.
Det digitala landskapet är fullt av dokument, kalkylblad, presentationer och olika format som sällan talar samma språk. Om du någonsin har behövt omvandla en envis PDF, en Excel-tabell eller till och med en bild till en ren, strukturerad Markdown har du förmodligen stött på många hinder. Här är MarkItDown – ett verktyg som snabbt framstår som en självklar lösning för utvecklare, kunskapsarbetare och AI-entusiaster som längtar efter sömlös filkonvertering.
I den här djupgående guiden kommer vi att gå igenom exakt vad MarkItDown är, hur det sticker ut, vad som gör det otroligt populärt och hur du kan integrera det i dina dagliga arbetsflöden. Vi kommer att beröra alla vinklar, från dess tekniska skicklighet till verkliga användningsområden, tips, utvecklaralternativ och mer därtill . Spänn fast säkerhetsbältet för en detaljerad rundtur genom Microsofts imponerande verktygslåda med öppen källkod!
Vad är egentligen MarkItDown?
MarkItDown är ett lättviktigt Python-verktyg med öppen källkod, utvecklat och underhållet av Microsoft, som ger dig möjligheten att konvertera en mängd olika filformat till välstrukturerat Markdown-format. Även om det finns andra konverteringsverktyg där ute, utmärker sig MarkItDown för sitt fokus på att bevara dokumentåtergivning, struktur och viktiga data , vilket gör det ovärderligt inte bara för mänskliga läsare utan även för stora språkmodeller (LLM), AI-pipelines och sökindex som frodas med Markdown-indata.
Denna kraftfulla plattform är kompatibel med Python-versionerna 3.10 till 3.14 och, även om den är utformad för tekniska experter och utvecklare, är tillräckligt tillgänglig för avancerade användare som vill automatisera eller effektivisera dokumentarbetsflöden.
Varför får MarkItDown så mycket uppmärksamhet?
Sedan den offentliga lanseringen har MarkItDown exploderat i popularitet – och samlat tiotusentals GitHub-stjärnor på kort tid. Spänningen kommer till stor del från dess flexibilitet, modulära design och bredden av filtyper den kan hantera.
- Office-dokument (Word, PowerPoint, Excel): Konverterar allt från text till tabeller och listor samtidigt som rubriker och innehållsstruktur bevaras.
- Bilder (JPEG, PNG, GIF): Extraherar EXIF-metadata och kan generera rik alt-text eller detaljerade beskrivningar om den är ansluten till en LLM.
- Ljudfiler (MP3, WAV): Utför transkribering av tal till text för att extrahera meningsfullt innehåll – även från röstanteckningar eller inspelningar.
- Webb- och dataformat (HTML, JSON, XML, CSV): Förvandlar komplexa datastackar och tabeller till rena Markdown-ekvivalenter.
- Postnummer/Arkiv: Itererar igenom alla inkluderade filer och konverterar var och en efter behov.
- Video- och avancerad dokumentanalys (med Azure Content Understanding): Erbjuder multimodal konvertering, inklusive fältutdrag från fakturor, kvitton och multimediainnehåll.
Den största fördelen ligger i hur "tokeneffektiv" och kompatibel utdata är med populära AI-modeller. De flesta moderna LLM:er, från OpenAI:s GPT-4 till anpassade modeller, "talar" Markdown direkt. Microsoft noterar till och med att sådana modeller tränas med stora mängder Markdown-formaterad text, så att använda MarkItDown hjälper till att mata data till både människor och maskiner i sin mest lättsmälta form.
Filformat som stöds – vad kan MarkItDown hantera?
MarkItDown är särskilt värdefullt på grund av sitt breda filstöd. Här är en utförlig titt på vad det hanterar direkt ur lådan och med plugins:
- PDF: Textbaserad extrahering, med valfri OCR via plugins för skannade bildbaserade dokument.
- Word (.docx), PowerPoint (.pptx), Excel (.xlsx): Översätter Office-filer och bevarar text, struktur, tabeller, bilder och rubriker.
- Bilder (PNG, JPG, JPEG, GIF): Extraherar EXIF/metadata och kan använda LLM:er eller dedikerade plugins för att generera beskrivande alt-text.
- Ljud (MP3, WAV): Använder taligenkänning för att konvertera tal till Markdown-formaterad text.
- Webbformat och data (HTML, CSV, JSON, XML): Behåller layout och tabellstrukturer där det är möjligt, vilket ger dig Markdown-tabeller direkt från källinnehållet.
- ZIP-arkiv: Bearbetar innehåll rekursivt, vilket gör batchkonverteringar snabba och effektiva.
- YouTube-webbadresser: Hämtar och transkriberar videoinnehåll om insticksprogram är aktiverade.
- E-böcker (EPUB): Konverterar EPUB-filer till läsbara Markdown-filer.
Valfria beroenden utökar funktionaliteten: Du kan installera extra moduler beroende på om du behöver PDF, PowerPoint, DOCX, XLSX, ljudtranskription med mera. Kommandot pip install 'markitdown[all]' kommer att hämta allt, eller så kan du anpassa den för ditt användningsfall.
MarkItDown jämfört med andra filkonverteringsverktyg
Medan populära verktyg som textract erbjuder extraktion av flera format, fokuserar MarkItDown på Markdown-utdata som bevarar dokumentstrukturen. Det betyder att du inte bara får en textdump; du får rubriker, listor, tabeller och länkar representerade som äkta Markdown. Detta är en stor sak om du bryr dig om läsbar dokumentation, enkel migrering till kunskapsbaser eller sömlös inmatning i LLM:er för kontextmedvetna svar.
Hur fungerar MarkItDown under huven?
MarkItDowns arkitektur är ren, modulär och utformad för utbyggbarhet. Kärnlogiken finns i en DocumentConverter-klass, som alla filtypsspecifika konverterare ärver från. Dessa är dynamiskt registrerade, så stöd för nya eller nischade format kan enkelt läggas till av utvecklarcommunityn via plugins.
Till exempel:
- Office-filer: Verktyg som
mammothochpandasanvänds för konvertering till HTML, och omvandlas sedan till Markdown medBeautifulSoup. - PDF: Utvinningsmöjligheter
pdfminer, med plugin-program tillgängliga för OCR-funktioner på skannade filer. - audio: integrerar
speech_recognition(med Googles API som standard) för tal-till-text-konvertering, även om OpenAI- eller Azure-integrationer är möjliga för högre återgivning eller specifika användningsfall. - Bildfiler: Kan bearbeta EXIF-metadata som standard och anropa en LLM för att skapa beskrivningar på naturligt språk eller alt-taggar.
MarkItDown kan köras helt offline för filtyper som stöds eller ansluta till tredjeparts-API:er och plugins för avancerade extraheringsuppgifter, som OCR eller hämtning av YouTube-texter.
Integration med juridikexperter och AI-arbetsflöden
En av de bästa användningsområdena för MarkItDown är dess roll i att förbereda dokument för LLM-utbildning och AI-driven sökning. Oavsett om du samlar kontextkällor för chattrobotar eller migrerar företagswikier är Markdown en "sweet spot" – kompakt, lätt att analysera och vänlig mot både människor och maskiner. MarkItDowns fokus på tokeneffektivitet och strukturbevarande innebär att både automatiserade verktyg och mänskliga redigerare drar lika stor nytta av dess konverteringsresultat.
Moderna LLM-program, som de som erbjuds av OpenAI, fungerar bäst på strukturerat innehåll rikt på Markdown. MarkItDowns tillvägagångssätt ger dig därför en fördel i alla AI-anslutna arbetsflöden som kräver informationsutvinning eller kunskapsinhämtning.
Plugin-ekosystem – obegränsad formatutvidgning
Om kärnformaten inte täcker dina behov, stöder MarkItDown plugins från tredje part för att låsa upp ännu fler funktioner.
- Plugins kan lägga till stöd för specialiserade filtyper, avancerad OCR eller alternativa arbetsflöden för datautvinning.
- Hitta plugins med hjälp av #markitdown-plugin hashtaggen på GitHub, eller utveckla din egen genom att referera till
markitdown-sample-pluginförvaret. - Plugins är valfria och måste vara explicit aktiverade – vilket ger dig säkerhet och kontroll över din miljö.
En som sticker ut är plugin-programmet markitdown-ocr , som möjliggör neural OCR på PDF-, DOCX-, PPTX- och XLSX-filer för att extrahera text från inbäddade bilder med hjälp av visionsmodeller – inga separata bibliotek krävs!
Avancerade funktioner: Azure Document Intelligence och innehållsförståelse
För användare med avancerade extraheringsbehov – som högkvalitativ OCR, strukturerad fältextraktion eller multimodal innehållskonvertering – erbjuder MarkItDown integrationer med Azure Document Intelligence och Azure Content Understanding (CU).
- Azure-dokumentintelligens: Använder molnbaserad layoututvinning för komplexa PDF-filer och strukturerade dokument.
- Förståelse för Azure-innehåll: Tillhandahåller YAML-extraktion av front matter för domänspecifika fält (fakturabelopp, avtalsklausuler), stöder multimodala filer (ljud, video, bilder) och låter dig konfigurera anpassade analysverktyg.
Dessa integrationer har en kostnad (per API-anrop), men de möjliggör extrahering i företagsskala till molnarbetsflöden – avgörande när ditt användningsfall kräver precision eller stöd för flera format utöver lokala beräkningsmöjligheter.
Enkel installation och användning
- Installation via PyPI:
pip install 'markitdown[all]'(rekommenderas starkt för alla funktioner) - Via källa: Klona officiella GitHub-repo och följ installationsanvisningarna för maximal flexibilitet.
Command Line Tool
Om du älskar att arbeta i terminalen kommer MarkItDown med ett enkelt CLI. Kör bara:
nedsättning -o
Detta konverterar din fil och Markdown-resultatet släpps där du behöver det. Du kan länka kommandon för batchkonvertering eller automatisera det i skript.
python api
För utvecklare och automatiseringsproffs exponerar MarkItDown ett enkelt Python API:
från markitdown importera MarkItDown md = MarkItDown() resultat = md.convert('test.xlsx') print(resultat.markdown)
Detta gör det superenkelt att integrera MarkItDown i ETL-pipelines, datainmatningssystem eller arbetsflöden för AI-modellutbildning.
Virtuell miljö och beroendehantering
För att undvika beroendekonflikter är det bäst att installera MarkItDown i en dedikerad virtuell miljö. Du kan använda Pythons inbyggda venv, uv, eller Anaconda – skräddarsy konfigurationen till din utvecklingsstack och undvik att oavsiktligt förstöra andra Python-projekt.
Säkerhet och inmatningsvalidering
MarkItDown fungerar med samma behörigheter som din Python-process. Det betyder att du, precis som med nativ fil-I/O, måste vara uppmärksam på vilka filer och URL:er du skickar till den. Rensa och begränsa alltid otillförlitliga indata, särskilt om du integrerar MarkItDown i värdbaserade applikationer eller webbtjänster.
Använd det smalaste möjliga API:et för dina behov: håll dig till convert_local() för lokala filer, och använd endast convert() för bredare användningsområden, kontrollera vad verktyget har åtkomst till. Exponera inte konverteringspipelinen direkt för användaruppladdat innehåll utan validering och säkerhetsåtgärder uppströms.
Integrationer: Visual Studio Code Extension och onlineplattformar
Om du använder VS Code erbjuder MarkItDown ett sömlöst tillägg via Visual Studio Marketplace som placerar all kraft i Python-verktyget direkt i din editor.
- Högerklickskonvertering: Skapa Markdown-filer direkt från PDF, DOCX, PPTX, XLSX och mer – ingen terminal behövs. Välj bara dina filer i Utforskaren, högerklicka och välj "Konvertera till Markdown".
- Stöd för batch- och flerval: Konvertera flera filer samtidigt utan att lämna din IDE.
- Isolerad Python-miljö: Tillägget konfigurerar sin egen virtuella miljö och hanterar beroenden själv, vilket lämnar ditt system Python orört för maximal stabilitet.
- Utgångshantering: Förhindrar överskrivningar genom att skapa unikt numrerade utdatafiler och kan automatiskt öppna resultatet efter konvertering.
- Stödda format: Matchar Python-verktyget, med transparent hantering för bilder, arkiv och ljud. Obs: OCR för PDF-filer med endast bilder kräver plugin- eller LLM-konfiguration.
- Konfiguration och felsökning: Ändra inställningar för automatisk öppning och överskrivning, med tydliga aviseringar för fel eller tomma utdata.
För de som föredrar en webbbaserad metod låter plattformar som Markitdown Online dig ladda upp dina filer via webbläsaren och direkt få Markdown-utdata, perfekt för enkla kunskapsbasmigreringar eller skapande av AI-utbildningskorpus.
Vanliga användningsfall: Varför ska du bry dig?
- Migrera statisk dokumentation till redigerbar Markdown för tekniska wikis och företagsintranät.
- Förbereda dokument för inmatning i LLM-drivna chattrobotar och kunskapshämtningssystem.
- Batchutvinning av innehåll och metadata från stora mängder PDF-filer, Office-filer eller multimedieresurser.
- Utveckla automatiserade API-slutpunkter för filkonvertering som en del av större automatiseringsstackar (till exempel med FastAPI, Zapier eller n8n).
- Omvandla äldre format för sökmotorindexering eller arkivering av kunskapsbaser.
Tips, begränsningar och utvecklarmöjligheter
Även om MarkItDown är flexibelt finns det några saker du bör veta:
- PDF-begränsningar: Bildbaserade PDF-filer kräver OCR och kan förlora formatering vid extrahering. Du kan behöva köra dem genom ett förbehandlingsverktyg om du behöver rubriker och strukturella detaljer.
- Ljud och video: Inbyggd transkription är begränsad till enkel taligenkänning. För bättre återgivning, överväg att ansluta till Azure eller andra avancerade API:er.
- Anpassning: Den modulära kodbasen gör det enkelt att lägga till stöd för nya filformat eller integrera med externa tjänster. Bidrag från communityn uppmuntras – oavsett om det gäller buggfixar, nya formatplugins eller utökning av befintliga funktioner.
För alla som är intresserade av att driftsätta MarkItDown som ett API är hosting möjligt med hjälp av molnlösningar som erbjuder pay-as-you-go-slutpunkter. Plattformar som Leapcell stöder sömlösa, händelsestyrda API-driftsättningar – perfekt för att automatisera filkonverteringar mellan distribuerade team utan att hyra en hel server.
Få hjälp och bidra
MarkItDown-communityn är aktiv och välkomnar bidrag. Om du stöter på några problem är GitHub-problem, Marketplace Q&A och andra utvecklarkanaler de första stoppen för felsökning och idéer. Tänk på Microsofts uppförandekod och licensvillkor, särskilt om du bidrar till eller distribuerar modifierade versioner.
Om du vill utveckla en webbtjänst, skrivbordsapp eller kommandoradspaket som drivs av MarkItDown är det helt tillåtet och till och med uppmuntrat – behåll det bara som ett separat paket som refererar till huvudbiblioteket från PyPI ( se PyPI här ).
MarkItDown är ett mångsidigt verktyg som avsevärt kan effektivisera dokumenthanteringsarbetsflöden, tack vare stöd för en mängd olika format, stark Markdown-genomförbarhet och utökningsmöjligheter. Integrationen med AI-arbetsflöden och plugin-ekosystem gör det särskilt kraftfullt för automatisering och storskalig datainmatning.